Indice
Introduction
Les portails de données ouvertes se multiplient sur Internet. Ces portails visent à rendre les données disponibles publiques et accessibles aux citoyens comme aux entreprises.
Cependant, certains portails de données ouvertes ne sont pas régulièrement mis à jour, ou leurs données contiennent des erreurs de persistance. Il est donc crucial de savoir comment analyser correctement les données. déterminer la qualité de mise à jour de chaque portail, et améliorer la visualisation des valeurs obtenues afin qu'elles soient compréhensibles par tout utilisateur.
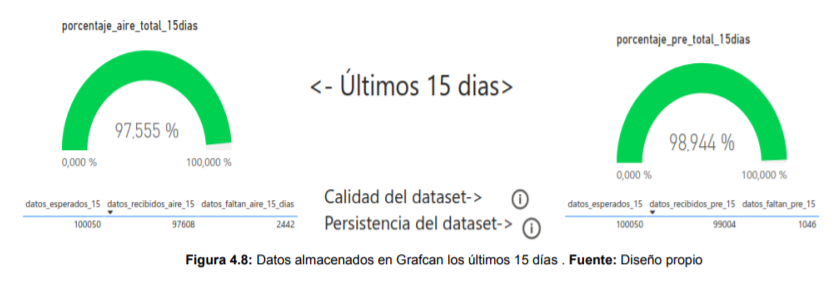
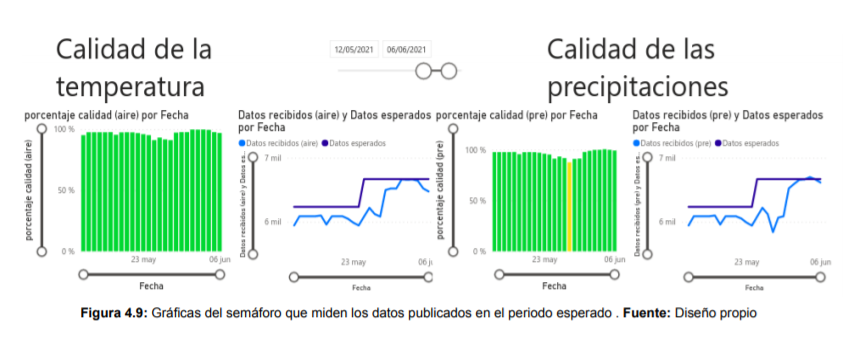
De cette façon, Un système de feux tricolores a été développé pour déterminer, en temps réel, la qualité des données de API météorologique GRAFCAN, En effet, il s'agit généralement d'un ensemble de données très précieux. Ce système de feux tricolores fournit des indicateurs sur la fiabilité des mises à jour de données, permettant ainsi aux entreprises et aux utilisateurs d'utiliser l'API en toute confiance.
En revanche, dans le contexte actuel de pandémie, l'utilisation des données ouvertes s'est avérée indispensable pour de nombreuses entreprises et citoyens, qui ont pu connaître en temps réel l'incidence cumulée des cas (ainsi que d'autres données pertinentes) dans leur région. Compte tenu de l'importance de ces données dans la société actuelle, il a été décidé Pour établir des prévisions sur l'incidence cumulée de la COVID-19 à Tenerife, à partir de données ouvertes.
Contexte
L'essor des données ouvertes ces dernières années a été extraordinaire. En Espagne, par exemple, en 2013, 5 000 jeux de données étaient disponibles sur différents portails officiels. Aujourd'hui, on en compte plus de 45 000. ensembles de données unifiés dans le même portail. Cette évolution a accru l'utilisation des données publiques par les citoyens, rendant plus nécessaire que jamais la surveillance des mises à jour des portails afin d'éviter les problèmes liés aux données obtenues.
Le projet aurait pu poursuivre l'étude d'autres portails selon une méthodologie similaire. Cependant, après une analyse manuelle, nous avons constaté que les données relatives à la COVID-19 sont mises à jour quotidiennement et présentent une fiabilité très élevée ; un système aussi complexe que celui créé avec GRAFCAN n'est donc pas nécessaire. En revanche, l'utilisation de ces données pour faire des prédictions est un domaine encore peu exploré et pourrait s'avérer plus pertinent pour cet ensemble de données spécifique.
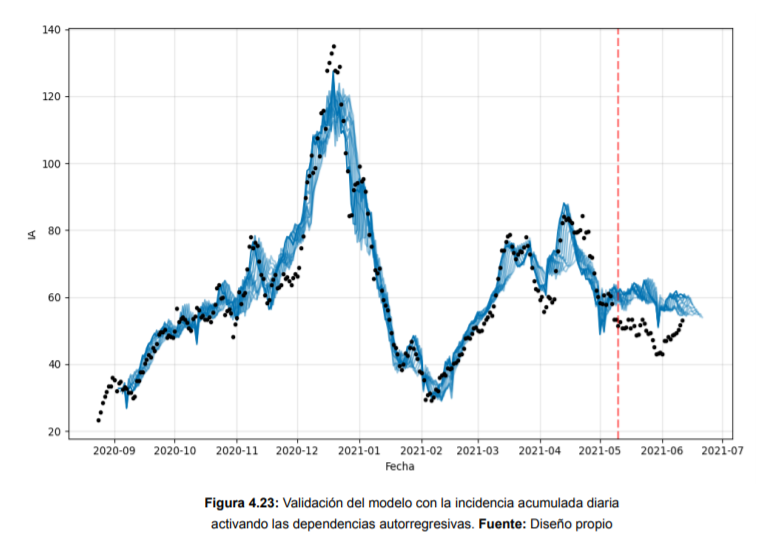
Pour comprendre le sujet des prédictions à partir des données sur la COVID-19, il est nécessaire d'expliquer ce qu'est une série chronologique. Une série chronologique peut être définie comme un ensemble d'observations d'une variable collectées séquentiellement au fil du temps. Les séries chronologiques possèdent quatre caractéristiques (composantes) qui permettent d'interpréter leur comportement ; ces caractéristiques sont détaillées dans le rapport. Les bibliothèques utilisées pour effectuer les prédictions sont : Prophète y Prophète neuronal.
Résumé du projet
Ce projet repose sur l'utilisation de données ouvertes. Afin d'évaluer la fiabilité des mises à jour de l'API GRAFCAN, une approche de Business Intelligence a été mise en œuvre, utilisant diverses stratégies et outils pour transformer des informations abstraites en connaissances exploitables. Plus précisément, quatre processus ETL ont été exécutés en Python pour acquérir et transformer les données. Par ailleurs, un tableau de bord a été créé avec Power BI, simulant un système de feux tricolores, permettant ainsi un suivi en temps réel des mises à jour et une meilleure ergonomie.
Les résultats montrent que l'API fonctionne correctement. L'ensemble de données obtenu est très volumineux, la qualité des données lors de leur première publication se situe généralement entre 92% et 97%, et leur persistance est adéquate.
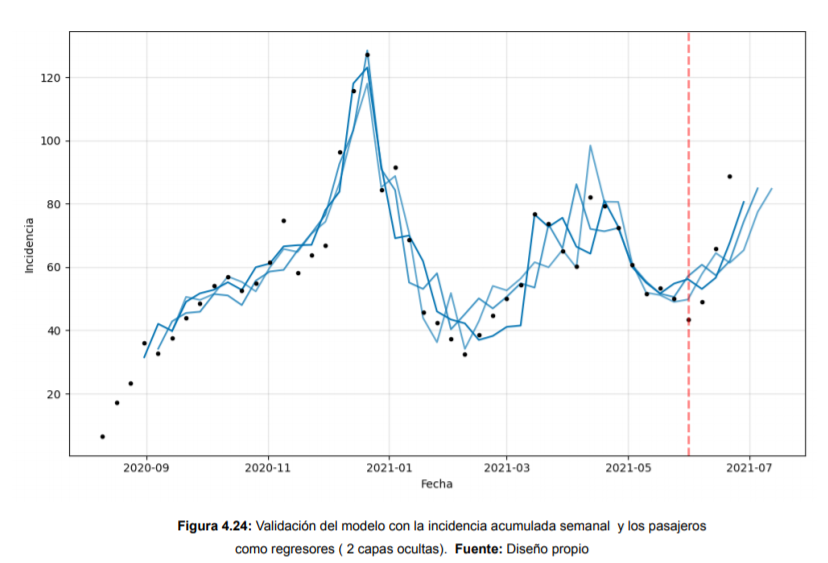
En revanche, en ce qui concerne ensemble de données Suite à l'analyse des données recueillies sur la COVID-19, des modèles prédictifs de l'incidence cumulée sur l'île de Tenerife ont été élaborés. Dans un premier temps, Prophet, une bibliothèque open source compatible avec Python et R, a été utilisée. Sa principale caractéristique réside dans l'interprétabilité de ses hyperparamètres, permettant de modéliser les tendances, les variations saisonnières et les périodes de vacances. Par la suite, Neural Prophet, une bibliothèque basée sur PyTorch qui combine l'interprétabilité de Prophet avec les réseaux de neurones, a été employée. Contrairement à Prophet, Neural Prophet permet l'ajout de régresseurs décalés – d'autres variables susceptibles d'améliorer la prédiction. C'est pourquoi les touristes britanniques et allemands se rendant à Tenerife ont été ajoutés comme régresseurs, car ils peuvent influencer la courbe d'incidence cumulée.
Dans ce projet de fin d'études, les résultats des deux modèles sont comparés, dans des conditions égales et avec les meilleurs hyperparamètres obtenus.
Plus d'informations
Le rapport sur les travaux est accessible au public sur le site web suivant : Dépôt institutionnel de l'Université de La Laguna.
- Auteur: Brian Samir Santamaría Valero
- Tuteur: José Luis Roda García
- Co-tuteur: Ginés León Rodríguez

